Warum viele Websites für ChatGPT unsichtbar sind (KI-generiert)
Inhaltsverzeichnis
Stell dir eine Fahrschule vor. Gute Website, ordentliche Google-Platzierungen, alles läuft. Nur: Wenn jemand ChatGPT fragt „Welche Fahrschule in meiner Stadt ist empfehlenswert?“, taucht sie nicht auf. Die Konkurrenz schon.
Der Grund liegt oft nicht im Text, nicht im Design und nicht in der Technik. Sondern in einer einzigen Zeile, die 2024 jemand eingebaut hat – mit den besten Absichten.
Damals ging eine Welle durch die Branche: KI-Bots aussperren. Niemand wollte, dass sein mühsam geschriebener Inhalt kostenlos in ein KI-Modell wandert. Also haben unzählige Agenturen und Webmaster pauschal gesperrt. Verständlich.
Das Problem: Viele dieser Sperren stehen heute noch da. Und sie bewirken inzwischen etwas anderes, als die Leute damals gemeint haben.
Zuerst kurz: Was ist eine robots.txt?
Auf fast jeder Website liegt eine kleine Textdatei namens robots.txt. Du erreichst sie, indem du an deine Adresse /robots.txt anhängst – also zum Beispiel deine-domain.de/robots.txt. Probier es ruhig gleich aus.
Diese Datei ist so etwas wie ein Zettel an der Eingangstür, den nur Besucher-Programme lesen. Darauf steht sinngemäß: „Google darf rein. Diese eine Unterseite bitte nicht anschauen. Und der da draußen bleibt ganz draußen.“
Jedes Programm, das deine Seite besuchen will, hat einen Namen – Fachbegriff: User-Agent. Google heißt Googlebot. Und hier fängt das Missverständnis an.
„Den einen KI-Bot“ gibt es nicht
Bei OpenAI (ChatGPT) und bei Anthropic (Claude) sind es nämlich mehrere Programme mit ganz unterschiedlichen Aufgaben. Und jedes wird auf dem Zettel einzeln angesprochen.
Am einfachsten stellst du dir drei Personen vor, die an deine Tür klopfen:
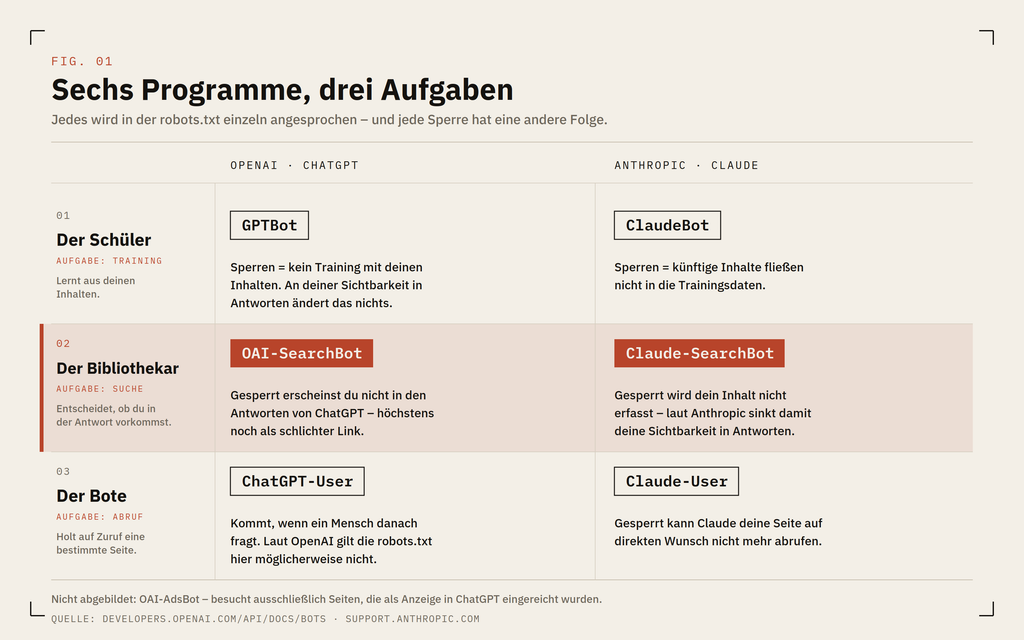
Der Schüler möchte deine Inhalte lesen, um daraus zu lernen. Was er lernt, fließt irgendwann in die nächste Version des KI-Modells ein. Bei OpenAI heißt er GPTBot, bei Anthropic ClaudeBot. Ihn auszusperren ist eine völlig legitime Entscheidung – und sie kostet dich keine Sichtbarkeit.
Der Bibliothekar führt einen Katalog. Wenn später jemand eine Frage stellt, schaut die KI in diesem Katalog nach, welche Websites sie empfehlen kann. Er heißt OAI-SearchBot beziehungsweise Claude-SearchBot. Das ist der Wichtige.
Der Bote holt auf Zuruf eine ganz bestimmte Seite. Jemand wirft deine Adresse in den Chat und fragt „Was steht da drin?“ – dann läuft der Bote los. Er heißt ChatGPT-User beziehungsweise Claude-User.
Zurück zum Beispiel: Jemand fragt ChatGPT „Wo kann ich in Regensburg glutenfrei essen?“. Ob dein Restaurant in der Antwort vorkommt, entscheidet allein der Katalog des Bibliothekars. Ob der Schüler jemals bei dir gelernt hat, spielt dafür keine Rolle.
Und genau hier wird OpenAI in der eigenen Dokumentation ungewöhnlich deutlich: Websites, die den Bibliothekar aussperren, werden in den Suchantworten von ChatGPT nicht angezeigt. Sie können bestenfalls noch als schlichter Link auftauchen. Anthropic schreibt sinngemäß dasselbe: Wer Claude-SearchBot blockiert, wird nicht mehr indexiert – und verliert damit Sichtbarkeit und Genauigkeit in den Antworten.
Wer 2024 pauschal alles gesperrt hat, hat also nicht nur den Schüler ausgesperrt. Er hat auch den Bibliothekar weggeschickt.
Ein Detail, das ich häufig sehe: In alten Dateien stehen noch die Namen Claude-Web und anthropic-ai. Die sind veraltet und werden nicht mehr verwendet. Wer nur die gepflegt hat, regelt heute gar nichts mehr.
Die zweite Tür, an die niemand denkt
Jetzt kommt der Teil, der in den meisten Artikeln zum Thema fehlt – und der in der Praxis mindestens genauso oft die Ursache ist.
Ein sauberer Zettel an der Tür nützt dir nichts, wenn davor ein Türsteher steht, der niemanden durchlässt.
Diesen Türsteher haben die meisten Websites, ohne es zu wissen. Er heißt Cloudflare, Sucuri, ein Sicherheits-Plugin oder einfach „der Bot-Schutz beim Hoster“. Seine Aufgabe ist es, Angriffe abzuwehren – und dabei weist er regelmäßig auch harmlose Besucher ab. Der Unterschied zum Zettel: Der Zettel ist eine höfliche Bitte, der Türsteher ist eine echte Sperre.
Beispiel aus der Praxis: Ein Malerbetrieb hat eine mustergültige robots.txt, alles erlaubt. Trotzdem taucht er nirgends auf. Der Grund war ein Sicherheits-Plugin, das jeden Besucher mit ungewöhnlichem Namen automatisch abgewiesen hat. Die KI-Programme haben angeklopft, eine Fehlermeldung bekommen und sind wieder gegangen. Auf der Website selbst ist davon nichts zu sehen.
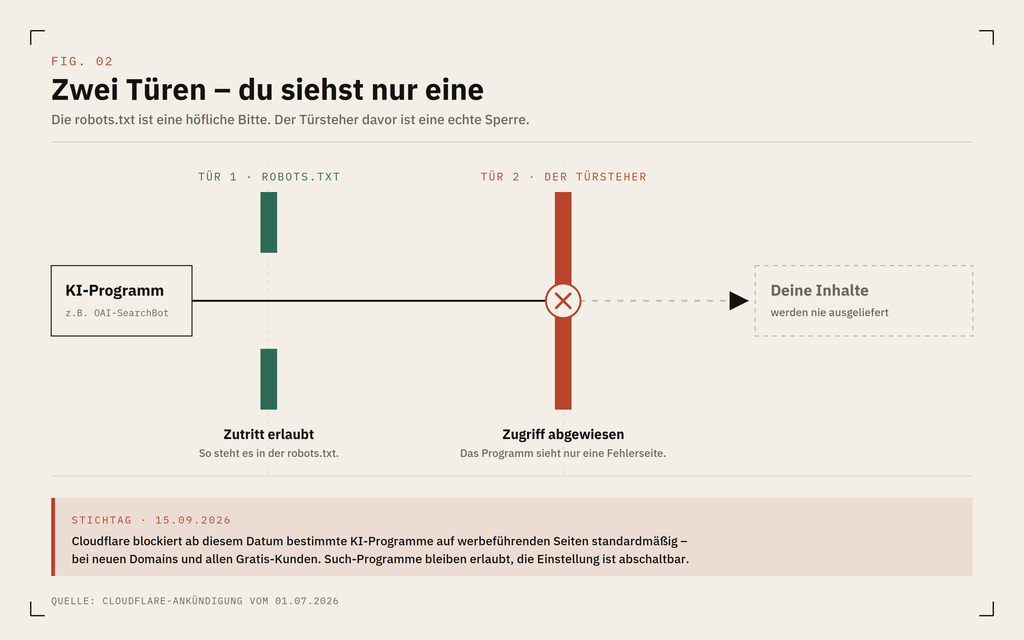
Dieser Punkt wird in den nächsten Wochen noch wichtiger. Cloudflare, das vor einem erheblichen Teil aller Websites weltweit sitzt, ändert am 15. September 2026 seine Voreinstellungen: Auf Seiten, die Werbung ausspielen, werden bestimmte KI-Programme dann standardmäßig blockiert. Betroffen sind neu angemeldete Domains und alle Kunden im Gratis-Tarif. Die Such-Programme bleiben erlaubt, und man kann die Einstellung abschalten – aber eben nur, wenn man weiß, dass es sie gibt.
Der Selbsttest in drei Schritten
Kein Fachwissen nötig. Zehn Minuten reichen.
Schritt 1: Den Zettel lesen
Ruf deine-domain.de/robots.txt im Browser auf. Du siehst einfachen Text. Suche mit Strg+F nach diesen Namen:
GPTBot · OAI-SearchBot · ChatGPT-User · ClaudeBot · Claude-SearchBot · Claude-User
Worauf du achtest:
- Steht hinter einem dieser Namen
Disallow: /, ist er komplett ausgesperrt. - Steht irgendwo
User-agent: *gefolgt vonDisallow: /, gilt das für alle Programme, die keinen eigenen Eintrag haben. Das ist die häufigste Falle. - Findest du gar nichts? Dann ist erst einmal nichts gesperrt – gut.
- Hast du Unterseiten auf einer eigenen Adresse, etwa
shop.deine-domain.de? Die brauchen ihre eigene robots.txt. Der Zettel gilt immer nur für eine Tür.
Schritt 2: Nachsehen, ob die Programme überhaupt ankommen
Der Zettel sagt dir, was erlaubt wäre. Ob es auch funktioniert, steht in den Besucherprotokollen deines Servers.
Wenn du da nicht selbst rankommst, schick deinem Hoster oder deiner Agentur einfach diesen Satz:
„Bitte prüft in den Server-Logs der letzten 30 Tage, ob Zugriffe von OAI-SearchBot, GPTBot, Claude-SearchBot und ClaudeBot ankommen – und mit welchem Statuscode sie beantwortet werden.“
Zwei Antworten sind interessant. Gar keine Zugriffe bedeutet: Es kommt schlicht nichts an. Zugriffe mit Statuscode 403 oder 429 bedeuten: Sie klopfen an, kommen aber nicht rein. Das ist der Fall, den fast niemand von selbst entdeckt.
Schritt 3: Beim Türsteher nachfragen
Wenn du Cloudflare nutzt, findest du im Dashboard unter Security die Einstellungen für Bots und KI-Crawler sowie eine Liste der abgewiesenen Zugriffe. Dort siehst du schwarz auf weiß, welche Regel wen weggeschickt hat.
Bei einem Sicherheits-Plugin in WordPress lohnt der Blick in dessen Protokoll und in die Einstellung „Bots blockieren“. Beim Hoster hilft dieselbe Frage wie oben.Für Technikaffine: derselbe Test in zwei Befehlen
# Kommen die Bots an – und mit welchem Statuscode?
grep -Ei 'OAI-SearchBot|GPTBot|ClaudeBot|Claude-SearchBot' \
  /var/log/nginx/access.log | awk '{print $9}' | sort | uniq -c

# Wie reagiert der Server auf einen Bot-Besuch?
curl -sI -A "compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" \
  https://deine-domain.de/ | head -1
Zum zweiten Befehl der Ehrlichkeit halber: Deine IP-Adresse gehört nicht zu OpenAI, ein 200 OK beweist also wenig. Kommt hier allerdings ein 403 oder eine Sicherheitsabfrage zurück, hast du definitiv eine Sperre im Weg, die nichts mit deiner robots.txt zu tun hat.
Was auf dem Zettel stehen sollte
Für einen normalen Betrieb – Handwerk, Gastronomie, Praxis, lokaler Handel – lautet die Antwort fast immer: alles erlauben.
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: GPTBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: ClaudeBot
Allow: /
Warum? Der Malerbetrieb verliert nichts, wenn seine Leistungsseite in einem KI-Modell landet. Aber er verliert eine Empfehlung, wenn er in der Antwort nicht vorkommt. Praktischer Nebeneffekt: Sind Schüler und Bibliothekar beide willkommen, holt OpenAI die Seite laut eigener Dokumentation unter Umständen nur einmal ab statt zweimal. Das schont deinen Server.
Anders sieht es aus, wenn dein Inhalt selbst das Produkt ist – bei einem Fachverlag etwa, einem Kursanbieter oder einer Rezeptdatenbank. Da ist die saubere Trennung sinnvoll: Bibliothekar und Bote hereinlassen, den Schüler draußen lassen.
User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Zwei Dinge noch, die gern untergehen. Erstens: Änderungen wirken nicht sofort. OpenAI nennt rund 24 Stunden, bis die eigenen Systeme eine neue robots.txt berücksichtigen. Zweitens: IP-Adressen zu sperren ist kein Ersatz. Anthropic weist ausdrücklich darauf hin, dass das nicht zuverlässig funktioniert – weil es die Programme daran hindert, den Zettel überhaupt zu lesen.
Fazit
Sichtbarkeit in KI-Antworten ist zu großen Teilen noch gar keine Optimierung. Es ist Aufräumen.
Bevor du dich mit Textstruktur, FAQ-Bereichen und Zitierfähigkeit beschäftigst, stell sicher, dass die Programme überhaupt hereinkommen. Ein Blick in eine Textdatei, eine Frage an den Hoster, ein Klick ins Dashboard.
Bei einem guten Teil der Websites, die ich mir anschaue, ist genau das der ganze Unterschied.
Über den Autor
Livio Bätschmann betreibt specialpage, eine Webdesign- und SEO-Agentur in Wolfhalden in der Ostschweiz. Seine Kundschaft sind kleine Betriebe – Garagen, Restaurants, Handwerker, Fahrschulen. Er hilft ihnen dabei, sich online so gut wie möglich zu präsentieren.
Website: specialpage.ch · Kontakt: info@specialpage.ch